
Aprendizaje profundo
Técnica de aprendizaje automático que entrena redes de neuronas artificiales organizadas en muchas capas sucesivas para extraer patrones complejos de los datos.
- Año
- 1986
- Protagonistas
- Geoffrey Hinton, Yann LeCun
- Sección
- Informática
Historia
El aprendizaje profundo es una rama del aprendizaje automático que utiliza redes de neuronas artificiales formadas por numerosas capas. Cada capa transforma los datos que recibe en una representación más abstracta: en una imagen, por ejemplo, las primeras capas pueden detectar bordes, las siguientes combinan esos bordes en formas y las últimas llegan a reconocer un rostro. Su importancia está en que el sistema aprende por sí mismo qué rasgos conviene extraer, en lugar de depender de reglas diseñadas a mano por especialistas.
Antes de este enfoque, buena parte del aprendizaje automático dependía de la ingeniería de características: expertos decidían qué medidas de una imagen o de una señal alimentaban al clasificador. Las redes neuronales tienen una historia anterior. En 1958, Frank Rosenblatt propuso el perceptrón, una red con una capa oculta cuyos pesos no aprendían, y el trabajo sobre redes con más capas que sí aprendieran quedó estancado durante años. Los avances llegaron por etapas. En 1965, Alexey Ivakhnenko y Lapa publicaron el método de manejo de datos por grupos, que suele considerarse el primer algoritmo de aprendizaje profundo funcional; un trabajo de 1971 describió una red de ocho capas entrenada con él. En 1967, Shun'ichi Amari publicó un perceptrón multicapa entrenado con descenso de gradiente estocástico, un método que ajusta los pesos poco a poco para reducir el error de la red.
Una pieza clave fue la retropropagación, una aplicación eficiente de la regla de la cadena del cálculo que reparte el error de la salida hacia las capas anteriores para corregirlas. Su forma moderna aparece en la tesis de Seppo Linnainmaa de 1970, y Paul Werbos la aplicó a redes neuronales en 1982. En 1986, David Rumelhart y sus colaboradores la popularizaron, aunque sin citar los trabajos originales. Ese mismo año, Rina Dechter introdujo el término «aprendizaje profundo» en la comunidad de aprendizaje automático. El origen del nombre es más complicado y no se asentó de inmediato, por lo que 1986 es una fecha aproximada.
En las décadas siguientes aparecieron arquitecturas concretas. En 1979, Kunihiko Fukushima presentó el neocognitrón, antecesor de las redes convolucionales, aunque no se entrenaba con retropropagación. En 1989, Yann LeCun y su equipo crearon LeNet para leer códigos postales manuscritos; el entrenamiento tardó tres días. LeNet-5, de 1998, fue usado por varios bancos para leer cifras manuscritas en cheques digitalizados. Por otro lado, Jürgen Schmidhuber propuso en 1991 una jerarquía de redes recurrentes preentrenadas capa a capa, y Sepp Hochreiter identificó ese mismo año el problema del gradiente que se desvanece, que dificulta aprender dependencias largas. La respuesta fue la memoria a corto y largo plazo (LSTM), publicada en 1995, a la que en 1999 se añadió la puerta de olvido, la versión que se convirtió en estándar. En 1985 y en la década siguiente, Geoffrey Hinton, Terry Sejnowski, Peter Dayan y otros desarrollaron modelos generativos como la máquina de Boltzmann, más costosos de entrenar que la retropropagación. En reconocimiento del habla, en cambio, los métodos neuronales tardaron mucho en superar a los modelos estadísticos tradicionales.
La recepción fue irregular. Durante los años noventa y comienzos de los dos mil, el interés se apagó en parte porque faltaban datos etiquetados y potencia de cálculo. El cambio llegó con el uso de tarjetas gráficas (GPU) para entrenar redes, capaces de realizar muchas operaciones en paralelo. Un análisis de OpenAI señaló que la cantidad de cálculo empleada en los proyectos más grandes creció 300.000 veces entre 2012 y 2017, con un tiempo de duplicación de unos 3,4 meses.
Hoy el aprendizaje profundo es la base de la visión artificial, del reconocimiento y la síntesis del habla, de la traducción automática y de los grandes modelos de lenguaje basados en transformers. También se usa en bioinformática, en el diseño de fármacos y en el análisis de imágenes médicas, donde las arquitecturas Vision Transformer han igualado o superado en algunos casos a las redes convolucionales. Aunque se inspiran en el cerebro, estos modelos no pretenden reproducir su funcionamiento, y su éxito depende tanto de los algoritmos como de los datos y del hardware disponibles.
Cronología
- 1965Ivakhnenko y Lapa publican el método de manejo de datos por grupos, considerado el primer algoritmo de aprendizaje profundo funcional.
- 1967Shun'ichi Amari publica un perceptrón multicapa entrenado con descenso de gradiente estocástico.
- 1979Fukushima presenta el neocognitrón, antecesor de las redes convolucionales.
- 1986Rumelhart y colaboradores popularizan la retropropagación, y Rina Dechter introduce el término aprendizaje profundo.
- 1989LeCun y su equipo crean LeNet para leer códigos postales manuscritos.
- 1995Se publica la memoria a corto y largo plazo (LSTM), una arquitectura recurrente para dependencias largas.
- 1998LeNet-5 se utiliza en bancos para leer cifras manuscritas en cheques.
- 2014El principio de las redes adversarias de Schmidhuber se aplica a las redes generativas adversarias (GAN).
Curiosidades y anécdotas
Un nombre con historia
La fecha de 1986 se asocia al término «aprendizaje profundo», pero su origen es complicado y el nombre se asentó despacio. La cifra exacta es, por tanto, aproximada.
La P de ChatGPT
Según un trabajo de Schmidhuber, la «P» de ChatGPT hace referencia al preentrenamiento, una idea que él había explorado en los años noventa.
 Geoffrey Hinton1947 · Informática
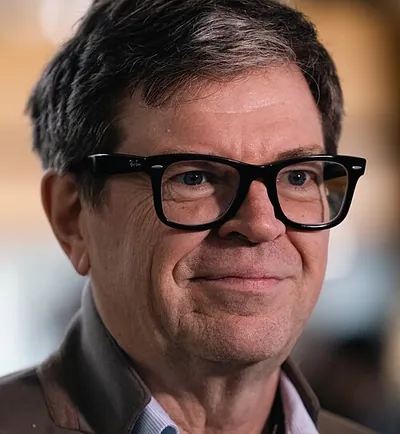 Yann LeCun1959 · Informática
