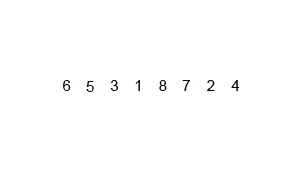
Ordenamiento por mezcla
Algoritmo de ordenación que parte una lista en mitades, ordena cada mitad y luego las mezcla en una sola lista ordenada.
- Año
- 1945
- Protagonistas
- John von Neumann
- Sección
- Informática
Historia
El ordenamiento por mezcla, conocido en inglés como merge sort, es un método para poner en orden una lista de elementos, ya sean números, palabras u otros datos comparables. Su interés reside en que siempre tarda en torno a n log n comparaciones, lo que lo hace muy eficiente incluso con listas grandes, y en que conserva el orden relativo de los elementos iguales. Su idea central es dividir y vencer: si una lista tiene uno o ningún elemento ya está ordenada; en otro caso se parte por la mitad, se ordena cada parte aplicando el mismo procedimiento y se combinan después las dos mitades ordenadas. Mezclar dos listas ya ordenadas es sencillo, porque basta con comparar los primeros elementos de cada una y tomar siempre el menor, lo que exige una sola pasada.
Antes de este método ya existían otros procedimientos de ordenación, como la ordenación por inserción o por selección, pero eran lentos con listas largas. La fusión de listas ordenadas era una técnica conocida en el trabajo manual y en las máquinas de clasificación de tarjetas perforadas, por lo que la novedad no estuvo tanto en la idea de mezclar como en formalizarla para un computador. El algoritmo suele atribuirse a John von Neumann, que lo desarrolló en 1945 durante los primeros años de la informática electrónica. Según los textos de referencia, una descripción detallada de la variante ascendente apareció en un informe de Herman Goldstine y von Neumann de 1948.
Con el tiempo se propusieron variantes. Una versión ascendente parte de listas de un solo elemento y las va fusionando por pasadas sucesivas, sin recursión. La versión natural aprovecha los tramos que ya vienen ordenados en la entrada, y de ella deriva Timsort, el método que usan muchos lenguajes modernos. También se diseñaron formas de reducir la memoria extra necesaria, que es el principal inconveniente del método sobre vectores, aunque a costa de complicar el código. Frente a otros algoritmos, como heapsort, que necesita muy poca memoria auxiliar, o quicksort, que suele ser más rápido en la práctica sobre vectores en memoria, el ordenamiento por mezcla destaca cuando los datos se leen en secuencia, como en listas enlazadas o en archivos en disco, y cuando se quiere paralelizar el trabajo.
Hoy el ordenamiento por mezcla está presente en bibliotecas estándar de numerosos lenguajes. El lenguaje Perl lo adoptó como método por defecto en su versión 5.8, y Java lo emplea para ciertos tipos de datos en sus métodos de ordenación de arrays. Su combinación de rendimiento predecible, estabilidad y buen comportamiento con datos secuenciales lo convierte en una pieza básica en la informática actual, desde la organización de bases de datos hasta el procesamiento de grandes volúmenes de información.
Cronología
- 1945John von Neumann desarrolla el ordenamiento por mezcla.
- 1948Un informe de Goldstine y von Neumann describe en detalle la variante ascendente.
- 2003Perl 5.8 adopta el ordenamiento por mezcla como método por defecto.
Curiosidades y anécdotas
Ventaja con listas enlazadas
El método es especialmente adecuado para listas enlazadas, donde el acceso aleatorio es lento y otros algoritmos rinden peor.
 John von Neumann1903–1957 · Informática
